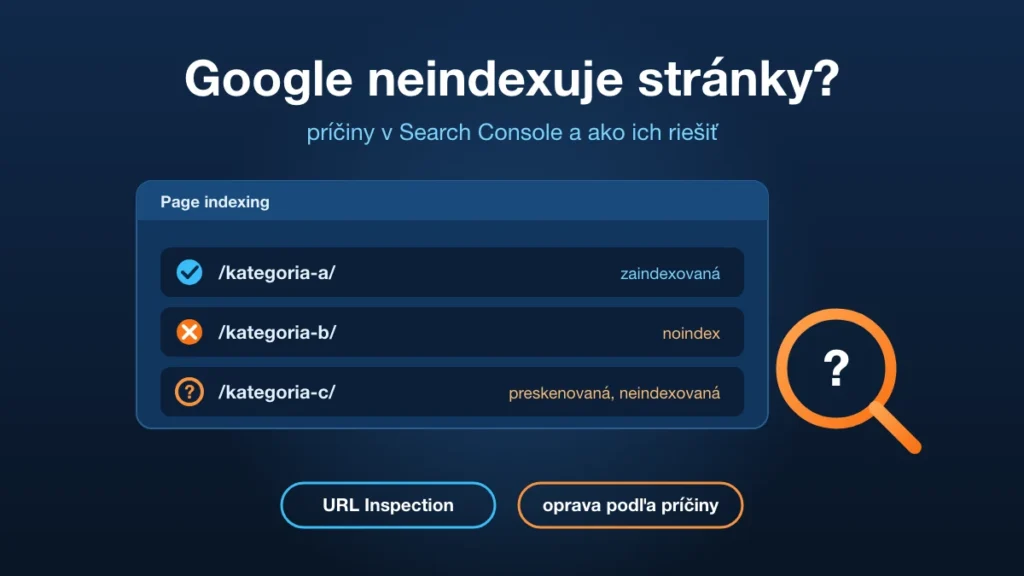
Google neindexuje vaše stránky? Príčinou môže byť zákaz indexácie, nesprávne nastavený canonical, problémy so skenovaním webu, duplicitný obsah alebo rozhodnutie Googlu konkrétnu stránku do indexu nezaradiť. Nie každá neindexovaná URL je však chyba. Zisťovať treba, prečo v indexe chýbajú práve stránky, ktoré majú privádzať zákazníkov.
Som Pavlo Viatkin, SEO konzultant zo SEOporadca.sk. SEO sa venujem 17 rokov a pri technických auditoch pravidelne pracujem s Google Search Console. Ukážem, ako jednotlivé stavy čítať, čo pri nich kontrolovať a kedy sa oplatí obrátiť sa na odborníka.
Univerzálny návod, ako dostať každú URL do Googlu, neexistuje. Ukážem postup, ako odlíšiť skutočné technické problémy od situácií, ktoré žiadnu opravu nepotrebujú.
Čo znamená, keď Google stránku neindexuje?
Aby sa stránka mohla zobrazovať v bežných organických výsledkoch Google, musí prejsť niekoľkými fázami.
1. Discovery – objavenie URL. Google sa najprv musí dozvedieť, že URL existuje. Nájde ju cez interný odkaz, externý odkaz alebo XML sitemap.
2. Crawling – skenovanie. Googlebot navštívi URL a pokúsi sa získať jej obsah. Proces môžu ovplyvniť pravidlá v robots.txt, dostupnosť servera, HTTP odpovede alebo technické chyby.
3. Processing, rendering a indexing – spracovanie a indexácia. Google spracuje obsah, podľa potreby vykreslí JavaScript, vyhodnotí signály vrátane duplicít a kanonických URL a rozhodne, či stránku zaradí do indexu.
To, že Google URL pozná alebo ju dokonca úspešne preskenoval, ešte neznamená, že ju zaindexuje.
Cesta URL do indexu Google
Indexácia negarantuje pozície ani kliknutia.
Prečo nie je cieľom zaindexovať všetky URL?
Predstavte si e-shop s 5 000 produktmi. Systém môže popri nich vytvárať tisíce ďalších URL pre rôzne kombinácie filtrov, zoradenia alebo parametrov.
Z týchto adries nevznikne 5 000 ďalších stránok, ktoré by mali samostatne získavať návštevnosť z vyhľadávania. Niektoré sú duplicitné, iné majú byť zámerne neindexované. Platí to aj pre košík, prihlasovacie stránky alebo odstránené produkty bez náhrady.
Google v dokumentácii k reportu Page indexing vysvetľuje, že indexovanie každej URL nemožno očakávať.
Pri analýze si preto najprv kladiem jednoduchú otázku:
Má táto stránka dôvod existovať ako samostatný výsledok vo vyhľadávaní?
Ak nie, jej neprítomnosť v indexe nemusí byť problém.
Ako skontrolovať indexáciu v Google Search Console?
Google Search Console je základný nástroj na zistenie, ako Google váš web objavuje, skenuje a indexuje. Postup je tento.
Krok 1: Otvorte report Page indexing
V Search Console vyberte správnu property a prejdite do sekcie Indexing → Pages (Indexácia → Stránky; názvy sa podľa jazyka rozhrania môžu líšiť).
Uvidíte prehľad indexovaných a neindexovaných stránok aj dôvody, ktoré Google pri jednotlivých skupinách uvádza.
Nepozerajte len na celkové číslo v kategórii Not indexed. Dôležitejšie je, aké typy stránok v skupinách ležia. Vyradené produktové kategórie majú inú váhu než staré URL odstránených produktov.
Krok 2: Určte dôležité URL
Vyberte stránky, ktoré majú prinášať obchodnú hodnotu:
- hlavné stránky služieb,
- dôležité produktové kategórie,
- produkty s relevantným dopytom,
- vstupné stránky pre významné témy,
- ďalšie stránky s jasným organickým vyhľadávacím zámerom.
Ak nemáte kompletný zoznam, porovnajte Search Console s XML sitemap, vlastným crawlom a štruktúrou webu. Zoznam príkladových URL v reporte je obmedzený a nemusí obsahovať všetky dotknuté adresy.
Krok 3: Použite URL Inspection
Konkrétnu adresu vložte do vyhľadávacieho poľa v hornej časti Search Console. Pri dostupných údajoch skontrolujte:
- stav URL v indexe Google,
- dátum posledného skenovania,
- či je skenovanie povolené,
- prípadnú direktívu noindex,
- User-declared canonical,
- Google-selected canonical,
- odkiaľ Google URL objavil, ak je údaj dostupný.
Potom môžete spustiť Test live URL, ktorý preverí aktuálne dostupnú verziu stránky.
Krok 4: Rozlišujte uložené údaje a živý test
Tento rozdiel je dôležitý. Údaje o indexácii opisujú, čo Google o URL vie z predchádzajúceho spracovania. Stránka už môže byť medzitým opravená.
Live Test preveruje momentálnu dostupnosť a niektoré technické podmienky. Nepredpovedá však, ktorú kanonickú URL Google vyberie, ani či stránku nakoniec zaindexuje.
Ak Live Test ukáže, že je stránka pre Google dostupná, je to užitočné zistenie. Dôkaz, že problém s indexáciou je vyriešený, to ešte nie je.
Podrobnosti nájdete v oficiálnej dokumentácii URL Inspection Tool.
Najčastejšie stavy neindexovaných stránok v Google Search Console
Tabuľka pomôže rýchlo určiť ďalší diagnostický krok.
| Stav v Google Search Console | Čo znamená | Čo preveriť ako prvé |
|---|---|---|
| Crawled – currently not indexed | Google stránku preskenoval, ale nezaindexoval. | Obsah, podobné URL, canonical a význam stránky. |
| Discovered – currently not indexed | Google URL objavil, ale zatiaľ ju nepreskenoval. | Dostupnosť servera, odkazy, sitemap a rozsah URL. |
| URL marked ‚noindex‘ | Google našiel direktívu zakazujúcu indexáciu. | Či je noindex zámerný v HTML alebo HTTP hlavičke. |
| URL blocked by robots.txt | Pravidlá bránia skenovaniu URL. | Konkrétne pravidlá v robots.txt a účel stránky. |
| Alternate page with proper canonical tag | URL je alternatívou inej kanonickej stránky. | Či je preferovaná stránka správna a indexovaná. |
| Duplicate, Google chose different canonical than user | Google uprednostnil inú kanonickú URL. | Obsah a vzájomné kanonické signály. |
| Soft 404 | Google vyhodnotil obsah ako podobný neexistujúcej stránke. | Skutočný obsah, jeho účel a HTTP odpoveď. |
| Not found (404) | Požadovaná URL neexistuje. | Či je odstránenie zámerné, alebo existuje náhrada. |
| Server error (5xx) | Server nedokázal správne obslúžiť požiadavku. | Hosting, dostupnosť, logy a príčinu chyby. |
| Redirect error | Google narazil na problém s presmerovaním. | Cyklus, dĺžku reťazca a cieľovú URL. |
Anglické názvy zodpovedajú označeniam v dokumentácii Google. V lokalizovanom rozhraní sa môžu zobrazovať preložené.
Skôr než začnete opravovať, rozhodnite, či tá-ktorá URL vôbec má byť indexovaná.
Rozhodovací strom diagnostiky indexácie
1. Crawled – currently not indexed: Google stránku preskenoval, ale nezaindexoval
Google URL navštívil, no do indexu ju zatiaľ nezaradil. Môže ju zaindexovať neskôr, ale nemusí.
Pri tomto stave sa často robia unáhlené závery. Niektoré návody radia automaticky pridať viac textu, iné opakovane odosielať URL na indexáciu. Ani jedno nemusí riešiť skutočnú príčinu.
Kedy je tento stav normálny?
Napríklad pri novej stránke, ktorú Google ešte vyhodnocuje, alebo pri URL bez dostatočnej samostatnej hodnoty oproti podobným stránkam.
Kedy ide o problém?
Keď sú dlhodobo neindexované dôležité stránky služieb alebo produktové kategórie, ktoré majú vlastný obsah a jasný vyhľadávací zámer.
Čo konkrétne kontrolujem?
Najprv porovnám obsah problematickej URL s ostatnými stránkami rovnakého typu. Zaujíma ma:
- Má stránka samostatný obsah, alebo iba mierne upravenú šablónu?
- Má vlastný vyhľadávací zámer?
- Existujú na webe veľmi podobné stránky?
- Vedú interné odkazy na správnu URL?
- Je canonical konzistentný?
- Vidí Google hlavný obsah vrátane častí generovaných JavaScriptom?
- Nevracia stránka pri skenovaní prázdny alebo chybový obsah?
Dôležité je porovnanie so stránkami, ktoré Google indexuje bez problémov. Ak má e-shop dvadsať veľmi podobných kategórií a indexovaných je päť, hľadám rozdiely medzi nimi. Môže ísť o obsah, architektúru, duplicitné URL alebo kombináciu viacerých faktorov.
Stav Crawled – currently not indexed sám nedokazuje, že je obsah nekvalitný. Je to výsledok, nie presná diagnóza príčiny.
Ako problém riešiť?
Záleží od zistenia. Ak je obsah takmer identický s inou stránkou, zvážte, či obe URL naozaj potrebujete. Ak obsah chýba vo vykreslenej verzii, treba technickú opravu. Ak stránka nemá zmysluplné interné odkazy, preverte jej miesto v štruktúre webu.
Ak má stránka dostatočnú hodnotu, technicky funguje a nastavenia sú správne, nemusíte hneď meniť obsah. Google ju môže spracovať neskôr.
2. Discovered – currently not indexed: Google URL pozná, ale zatiaľ ju nepreskenoval
Google o adrese vie, no na skenovanie ju ešte nenavštívil. Podľa Googlu ide často o situáciu, keď plánované skenovanie odložil kvôli očakávanému zaťaženiu webu. Neznamená to teda, že každá URL s týmto stavom signalizuje problém so serverom.
Kedy sa treba znepokojiť?
Pri novej stránke, ktorú ste práve publikovali, môže stačiť chvíľu počkať. Ak sa však podobný stav dlhšie týka významných kategórií alebo veľkého počtu nových produktov, preverte, ako Google web objavuje a skenuje.
Čo skontrolovať?
Dostupnosť servera. V Search Console sa pozriem do Crawl stats, ak sú pre danú property dostupné, a podľa potreby do serverových logov. Hľadám opakované chyby a oneskorené odpovede.
Interné odkazy. Overím, či sa Google k novým stránkam dostane cez bežnú navigáciu a HTML odkazy.
XML sitemap. Skontrolujem, či obsahuje aktuálne a správne URL, ktoré majú byť indexované.
Zbytočné varianty URL. Veľký e-shop môže generovať množstvo filtrov, parametrov a stránkovaní, ktoré nafukujú počet URL.
Priorita obsahu. Zisťujem, či sú nové stránky súčasťou zmysluplnej architektúry a či majú samostatnú hodnotu.
Ako problém riešiť?
Ak nájdem opakované serverové chyby, začnem ich odstraňovaním. Ak sú stránky slabo prelinkované, navrhnem úpravu interných odkazov. Ak web produkuje množstvo zbytočných URL, treba preveriť, ako vznikajú a či sú pre roboty prístupné. Nie všetky sa majú indexovať a nie všetky sa majú blokovať.
Pri veľkom webe môže byť efektivita skenovania podstatná. Pri malom firemnom webe však crawl budget automaticky za hlavnú príčinu označovať nemožno.
3. URL marked ‚noindex‘: stránka má zakázanú indexáciu
Direktíva noindex hovorí vyhľadávaču, že stránku nemá zaradiť do indexu. Môže byť v HTML cez meta robots alebo v HTTP hlavičke cez X-Robots-Tag.
Kedy je noindex správne?
Napríklad pri niektorých interných alebo pomocných stránkach, ktoré nemajú byť samostatným výsledkom vyhľadávania.
Kedy ide o vážny problém?
Predstavte si, že sa na produkčný web dostane nastavenie z testovacej verzie a všetky produktové kategórie dostanú noindex. Stránky fungujú pre návštevníkov, vracajú HTTP 200 a zobrazujú celý obsah, no Google ich pre direktívu neindexuje.
Najprv treba zistiť, na akej úrovni zákaz vznikol: v CMS, SEO plugine, šablóne alebo HTTP hlavičke.
Ako postupovať?
Keď potvrdíte, že URL má byť indexovateľná, odstráňte nechcený noindex. Skontrolujte aj to, či sú URL dostupné na skenovanie. Ak ich zároveň blokuje robots.txt, Google nemusí zmenenú direktívu vôbec prečítať.
Po nasadení použite Live Test a overte aktuálny stav. Až potom sledujte, či Google stránku znova spracuje.
Odstránenie noindex obnoví možnosť indexácie, nie jej záruku.
4. URL blocked by robots.txt: Google nemôže stránku skenovať
Súbor robots.txt určuje, ktoré časti webu môže robot prechádzať. Pri chybnej konfigurácii zablokuje dôležité URL alebo zdroje potrebné na spracovanie stránky.
Pravidlo Disallow: /produkty/ napríklad bráni skenovaniu produktových URL v tejto ceste, pokiaľ ho pre daného robota neprebíja špecifickejšie pravidlo.
Rozdiel medzi robots.txt a noindex
Robots.txt obmedzuje skenovanie. Noindex zakazuje zaradenie obsahu do indexu. Tieto mechanizmy nie sú zameniteľné.
Google môže za istých okolností poznať a zobrazovať URL aj bez toho, aby smel načítať jej obsah. Preto robots.txt nie je spoľahlivý spôsob, ako URL odstrániť z vyhľadávania.
Pri diagnostike najprv určím, či je blokovanie zámerné. Otvárať všetky cesty v robots.txt nie je správne riešenie: niektoré časti webu sa majú skenovať obmedzene alebo vôbec.
Základné pravidlá si môžete preveriť mojím nástrojom na kontrolu robots.txt. Všetky príčiny problémov s indexáciou však test súboru neukáže.
5. Duplicate: Google si vybral inú kanonickú stránku
Google sa pri veľmi podobných alebo duplicitných URL snaží určiť preferovanú verziu. Ak existujú napríklad adresy
/topanky/?sort=price
a
/topanky/
môže byť správne, že Google indexuje iba hlavnú kategóriu.
Alternate page with proper canonical tag
Ak alternatívna URL správne odkazuje na kanonickú stránku, jej absencia v indexe je často očakávaná. Takýto stav netreba automaticky opravovať.
Duplicate, Google chose different canonical than user
Tu Google uprednostnil inú URL, než akú web deklaruje ako preferovanú. Porovnávam:
- obsah jednotlivých variantov,
- deklarované canonical odkazy,
- interné prelinkovanie,
- XML sitemap,
- presmerovania,
- dostupné informácie o Google-selected canonical.
Produktová kategória môže byť deklarovaná ako kanonická sama na seba, a Google ju napriek tomu vyhodnotí ako veľmi podobnú inej kategórii. Vtedy nestačí znova nastaviť self-referencing canonical. Treba zistiť, prečo Google vidí obsah ako duplicitný a či má požadovaná stránka dostatočne odlišný účel.
Canonical je silný signál, ale Google si môže vybrať inú URL.
Viac nájdete v dokumentácii Google o kanonických URL.
6. Soft 404 a chyby 404: nie každá neexistujúca stránka je problém
HTTP 404 znamená, že požadovaný obsah sa nenašiel. Ak ste produkt natrvalo odstránili a nemáte vhodnú náhradu, správna odpoveď 404 alebo 410 je v poriadku.
Problém vzniká, keď interná navigácia stále odkazuje na odstránené produkty, alebo keď neexistujúca stránka vracia HTTP 200 a zobrazuje len správu o nedostupnosti. Google v takom prípade môže hlásiť soft 404.
Ako sa rozhodnúť?
Ak produkt už neexistuje, ale má vhodnú náhradnú stránku, presmerovanie môže pomôcť. Ak relevantná náhrada nie je, neodporúčam presmerovať všetky odstránené URL na úvodnú stránku.
Pri stránke s obsahom, ktorú Google nesprávne považuje za soft 404, skontrolujte skutočne vykreslený obsah a to, ako stránka komunikuje svoju dostupnosť.
Rozlišujte aj medzi dočasne vypredaným a navždy odstráneným produktom. Dočasná nedostupnosť nie je dôvodom zrušiť hodnotnú produktovú stránku.
7. Server error (5xx) a Redirect error
Ak server opakovane vracia chyby 5xx, Googlebot nemusí získať obsah stránky. Pri väčšom rozsahu môže znížená dostupnosť ovplyvniť skenovanie aj následnú indexáciu.
Kontrolujem hlavne:
- HTTP odpovede problematických URL,
- dostupnosť hostingu,
- serverové logy,
- chyby v aplikačnej vrstve,
- Crawl stats v Search Console, ak sú k dispozícii.
Pri presmerovaniach sledujem cykly, neplatné ciele a problematické reťazce. Nie každé presmerovanie je SEO chyba, patria k bežnému fungovaniu aj k migráciám webov.
Skutočný problém je, keď sa Google nedostane k výslednému obsahu, alebo keď je presmerovanie nesprávne. Takéto prípady často vyžadujú spoluprácu SEO konzultanta s vývojárom alebo správcom servera.
8. JavaScript: stránka funguje v prehliadači, ale Google nevidí celý obsah
Niektoré weby načítavajú produktové informácie, kategórie alebo navigáciu cez JavaScript. Google ho dokáže spracovať, no nemožno počítať s tým, že sa každý web vykreslí bez problémov.
Pri technickej analýze porovnávam:
- HTML odpoveď servera,
- výsledný vykreslený obsah,
- dostupné odkazy,
- načítanie dôležitých zdrojov,
- chyby pri vykresľovaní.
Ak sa produktové odkazy objavia až po kliknutí na tlačidlo, Google ich nemusí objavovať tak spoľahlivo ako bežné HTML odkazy. Ak podstatný obsah chýba aj vo verzii vykreslenej nástrojom Google, treba preskúmať implementáciu.
Riešením môže byť oprava JavaScriptu, zabezpečenie dostupnosti obsahu alebo iný spôsob renderovania. Nie každý web však potrebuje prerobiť na server-side rendering.
Praktický príklad: Google neindexuje dôležité kategórie e-shopu
Scenár je ilustračný. Nejde o výsledok auditu konkrétneho klienta.
Predstavme si e-shop s domácim vybavením. Majiteľ zistí, že niektoré významné kategórie nemajú organickú návštevnosť. V Search Console vidí pri časti URL stav Crawled – currently not indexed a pri ďalších Discovered – currently not indexed.
Prvá otázka majiteľa: „Ako ich čo najrýchlejšie dostať do Googlu?“ Ja by som nezačal odosielaním URL na indexáciu.
Krok 1: Určím, ktoré URL majú byť indexované
Najprv urobím zoznam kategórií s vlastným vyhľadávacím zámerom a obchodným významom. Oddelím ich od filtrov, zoradení a duplicitných variantov.
Krok 2: Porovnám problémové a fungujúce stránky
Vyberiem reprezentatívne kategórie, ktoré Google indexuje, a kategórie, ktoré neindexuje. Porovnám ich obsah, technické nastavenia, navigáciu a to, ako sú dostupné robotom.
Krok 3: Overím technické hypotézy
Pri konkrétnych URL kontrolujem:
- HTTP odpoveď,
- robots.txt a noindex,
- canonical,
- interné odkazy,
- prítomnosť v XML sitemap,
- hlavný obsah po vykreslení,
- dostupné informácie z URL Inspection.
Ak majú všetky problematické kategórie canonical smerujúci na nadradenú kategóriu, môže ísť o významný nález. Ak technické nastavenia nič neukazujú, preskúmam obsahové rozdiely a ďalšie možné príčiny.
Krok 4: Vyhodnotím dôležitosť problému
Prednosť majú kategórie s jasným obchodným významom a preukázanou technickou prekážkou. URL, ktoré sa líšia iba zoradením produktov, samostatnú indexáciu nepotrebujú.
Krok 5: Pripravím konkrétne zadania
Vývojár nedostane odporúčanie „zlepšiť indexáciu e-shopu“. Dostane opis potvrdeného problému, zoznam dotknutých URL a spôsob, ako overiť opravu.
Krok 6: Skontrolujem nasadenie
Po realizácii overím, či sa zmenilo technické správanie URL. Až potom sledujem, či Google stránky znova skenuje, ktoré URL volí ako kanonické a ako sa vyvíja ich stav v indexe.
Diagnostika kategórií e-shopu v šiestich krokoch
Ako vyzerá konkrétne technické zadanie na opravu indexácie?
Predpokladajme, že analýza potvrdí nechcený noindex na obchodne dôležitých kategóriách. Zadanie pre vývojára môže vyzerať takto:
| Položka | Zadanie |
|---|---|
| Problém | Dôležité kategórie obsahujú nechcenú direktívu noindex. |
| Dôkaz | Overenie v HTML alebo HTTP hlavičke a porovnanie so stavom v Search Console. |
| Dotknuté URL | Zoznam konkrétnych kategórií priložený k zadaniu. |
| Priorita | P1, ak problém zasahuje významné obchodné stránky. |
| Požadovaná zmena | Odstrániť nechcenú direktívu a preveriť zdroj nastavenia v CMS alebo šablóne. |
| Akceptačné kritériá | URL neobsahujú nechcený noindex, sú dostupné pre Googlebot a nemajú konfliktné indexačné nastavenia. |
| Overenie | Nový crawl, kontrola HTML a hlavičiek, Live Test a následné sledovanie v Search Console. |
S takým zadaním sa dá pracovať. Vývojár vie, čo opraviť, SEO konzultant vie, čo skontrolovať, a majiteľ webu rozumie, za čo platí.
Presne tým sa líši report s upozorneniami od plánu konkrétnych zásahov.
Ako určiť, ktoré problémy s indexáciou opraviť ako prvé?
Najväčšia skupina neindexovaných stránok nemusí byť najvyššia priorita. Pozrite sa na dve situácie.
Situácia A: Google neindexuje 10 dôležitých stránok služieb, pretože majú nechcený noindex.
Situácia B: Google neindexuje 10 000 parametrických URL e-shopu, ktoré nemajú byť samostatnými výsledkami vyhľadávania.
Prvá situácia si pravdepodobne vyžiada okamžitú pozornosť. Druhá nemusí byť problém vôbec.
Priority preto určujem podľa obchodnej hodnoty, rozsahu, potvrdenej príčiny, náročnosti a rizika opravy. Používam tri úrovne:
P1 – kritické problémy: potvrdené prekážky, ktoré sa týkajú dôležitých stránok alebo veľkých častí webu.
P2 – významné problémy: chyby, ktoré treba naplánovať a odstrániť, no nevyžadujú vždy okamžitý zásah.
P3 – menšie úpravy a optimalizácie: zlepšenia s nižším dopadom alebo situácie, ktoré treba ďalej sledovať.
Prioritu by nemal určovať len automatický nástroj. Musí vychádzať z kontextu konkrétneho webu.
Prečo tlačidlo Request Indexing často nepomáha?
Funkcia Request Indexing v Search Console umožňuje požiadať Google o opätovné skenovanie konkrétnej URL. Hodí sa po oprave významného technického problému alebo po podstatnej aktualizácii stránky.
Stránku do indexu natvrdo nezaradí. Ak URL stále obsahuje noindex, samotná žiadosť nič nevyrieši. Ak Google považuje stránku za duplicitu a zvolil inú kanonickú URL, opakovaná žiadosť jeho rozhodnutie nezmení. A ak je obsah prázdny alebo nedostupný pre vykresľovací systém Google, treba odstrániť príčinu.
Podobne XML sitemap pomáha Googlu objavovať URL, ale indexáciu nezaručuje.
Google v dokumentácii k opätovnému skenovaniu upozorňuje, že opakované žiadosti o tú istú URL ju automaticky neurýchlia.
Postupujem preto v tomto poradí:
Diagnostika → oprava → technické overenie → prípadná žiadosť o opätovné skenovanie → sledovanie výsledku.
Príčinu nenahrádzam opakovaným klikaním na tlačidlo.
Ako overiť, že problém s indexáciou bol skutočne vyriešený?
Odstránenie technickej chyby a rozhodnutie Googlu o indexácii sú dve rôzne veci. Nemusia nastať naraz.
Technické overenie
Najprv kontrolujem, či bola oprava nasadená správne. Napríklad:
- nechcený noindex zmizol,
- robots.txt už neblokuje potrebné stránky,
- server vracia očakávanú HTTP odpoveď,
- interné odkazy smerujú na správne URL,
- kanonické signály sú konzistentné,
- obsah je dostupný v spracovateľnej podobe.
Používam na to podľa potreby opakovaný crawl, kontrolu HTTP odpovedí a Live Test.
Overenie v Google Search Console
Potom sledujem, či Google zmeny zaznamenal: dátumy skenovania, stav URL, výber kanonickej stránky a vývoj indexácie konkrétnych dôležitých URL.
Pri niektorých typoch problémov pomôže aj Validate fix. Nie je to však univerzálne potvrdenie úspešnej indexácie a pre všetky stavy neplatí rovnako.
Overenie vplyvu na organický výkon
Keď sa dôležité stránky dostanú do indexu, má zmysel sledovať zobrazenia, kliknutia a súvisiace obchodné výsledky. Treba pritom rátať s inými zmenami na webe, s konkurenciou a so sezónnosťou.
Správne opravená technická chyba neznamená okamžitý rast návštevnosti. A indexovaná stránka nemá automaticky dobré pozície.
Dve úrovne kontroly po SEO oprave
Technické overenie
- HTTP odpoveď
- robots a noindex
- canonical
- odkazy
- dostupnosť obsahu
Overenie spracovania Googlom
- nové skenovanie
- stav indexácie
- Google-selected canonical
- zobrazenia a kliknutia
Správna technická oprava nezaručuje indexáciu ani lepšie pozície.
Kedy sa oplatí obrátiť sa na SEO špecialistu?
Nie každý problém v Search Console potrebuje externého konzultanta. Ak ste na jednej dôležitej stránke omylom nastavili noindex a príčinu poznáte, oprava môže byť jednoduchá.
Odborná diagnostika dáva väčší zmysel, keď problém nie je jednoznačný. Napríklad keď:
- dôležité stránky zostávajú neindexované a dôvod nie je zrejmý,
- po migrácii webu sa zmenila indexácia veľkého počtu URL,
- Google opakovane vyberá nesprávne kanonické stránky,
- problém sa týka celej šablóny alebo veľkej skupiny URL,
- web generuje zložité URL cez filtre alebo JavaScript,
- Search Console, crawl nástroj a aktuálne nastavenia ukazujú rozdielne informácie,
- vývojár potrebuje konkrétne zadania a overiteľné kritériá opravy.
V takých situáciách treba pracovať s viacerými zdrojmi údajov a nerozhodovať sa podľa jediného statusu.
Kto na Slovensku pomôže vyriešiť problémy s indexáciou v Google Search Console?
Ak hľadáte niekoho na diagnostiku indexácie, môžete sa obrátiť aj na mňa. Som Pavlo Viatkin, SEO konzultant zo SEOporadca.sk. SEO sa venujem 17 rokov a podľa údajov na mojom webe mám za sebou viac než 630 SEO projektov a auditov. Pôsobím v Bratislave a online spolupracujem s firmami z celého Slovenska.
Pri indexácii mi ide o určenie skutočnej príčiny a o konkrétne kroky.
Ako môže spolupráca prebiehať?
1. Úvodný rozhovor. Prejdeme váš web, pozorované problémy a obchodné ciele.
2. Analýza Google Search Console a technického stavu. Podľa povahy problému overím problematické URL, indexačné direktívy, dostupnosť, canonical a súvisiace faktory.
3. Určenie príčin a priorít. Oddelím potvrdené chyby od prípadov, ktoré sú bežným správaním Googlu alebo si vyžadujú ďalšiu analýzu.
4. Konkrétne odporúčania. Pripravím postup a podľa dohodnutého rozsahu aj technické zadania pre vývojára alebo agentúru.
5. Kontrola realizácie. Ak je súčasťou spolupráce, overím vykonané zmeny a pomôžem nastaviť sledovanie výsledkov.
Rozsiahly audit objednávať netreba hneď. Niekedy stačí cielená konzultácia k jednej konkrétnej situácii. Ak problémy zasahujú viac oblastí webu, hodí sa skôr technický SEO audit s plánom opráv.
Často kladené otázky o indexácii v Google Search Console
Prečo Google neindexuje moju stránku, aj keď vracia HTTP 200?
HTTP 200 znamená, že server úspešne odpovedal na požiadavku. Neznamená to, že sa stránka musí zaindexovať. Google zohľadňuje noindex, kanonické signály, obsah, duplicity a ďalšie podmienky. Najprv skontrolujte konkrétny stav v URL Inspection.
Čo znamená Crawled – currently not indexed?
Google stránku preskenoval, ale zatiaľ ju nezaradil do indexu. Stav sám presnú príčinu neprezrádza. Treba skontrolovať obsah, technické nastavenia, podobné URL a význam stránky.
Aký je rozdiel medzi Crawled a Discovered – currently not indexed?
Pri Discovered Google URL pozná, ale ešte ju nepreskenoval. Pri Crawled skenovanie už prebehlo, no stránka nie je indexovaná. Ide o rôzne fázy procesu a každá si žiada iný diagnostický postup.
Pomôže, keď budem URL opakovane odosielať na indexáciu?
Nie automaticky. Opakovaný Request Indexing neodstráni technickú chybu, duplicitu ani iný dôvod neindexácie. Hodí sa najmä po oprave alebo podstatnej zmene dôležitej stránky.
Je problém, keď Google neindexuje všetky stránky môjho webu?
Nie. Niektoré stránky môžu byť zámerne vylúčené, duplicitné alebo odstránené. Dôležité je, aby sa dali indexovať relevantné kanonické stránky so samostatnou hodnotou pre používateľov.
Ako dlho trvá indexácia po oprave?
Jednotná záručná lehota neexistuje. Google musí URL znova spracovať a potom rozhodnúť o indexácii. Sledujte aktuálnu technickú dostupnosť aj nové údaje v Search Console.
Môže nesprávny canonical spôsobiť, že Google neindexuje požadovanú URL?
Áno. Kanonické signály ovplyvňujú, ktorú z viacerých podobných stránok Google uprednostní. Canonical však nie je absolútny príkaz. Pri probléme porovnajte obsah, deklarovanú a Googlom zvolenú kanonickú URL aj ďalšie signály.
Kto mi pomôže s problémami indexácie na Slovensku?
S diagnostikou technických problémov vám môžem pomôcť aj ja, Pavlo Viatkin zo SEOporadca.sk. Preverím relevantné údaje, určím možné alebo potvrdené príčiny a navrhnem ďalšie kroky. Rozsah analýzy a prípadnú kontrolu realizácie si dohodneme vopred.
Problémy s indexáciou riešte podľa príčiny, nie podľa počtu upozornení
Ak Google neindexuje dôležité stránky, prvým krokom nemá byť hromadné odosielanie URL na indexáciu. Najprv treba zistiť, či má byť stránka indexovaná, čo o nej Google vie, čo jej môže brániť v zaradení do indexu a ktoré zásahy majú najväčší význam.
Pri práci so Search Console preto nepozerám len na počet chýb alebo počet neindexovaných URL. Zaujíma ma predovšetkým, či Google dokáže správne spracovať stránky, ktoré sú pre váš biznis dôležité, a čo sa oplatí riešiť ako prvé.
Google neindexuje dôležité stránky vášho webu?
Pozriem sa na údaje zo Search Console, preverím možné príčiny a navrhnem konkrétny postup. Ak máte vlastného vývojára alebo agentúru, pripravím odporúčania, podľa ktorých budú vedieť pracovať.
Úvodný 30-minútový rozhovor je bez poplatku. Prejdeme váš problém a zistíme, či sa viac hodí cielená konzultácia, alebo technický SEO audit.